robots.txtで「AI学習に使わないで」と伝えられる?IETFのaiprefをやさしく解説
自分のサイトの文章が、知らないうちにAIの学習に使われるのは避けたい。そして、検索結果やAIの回答には、引き続き載せてほしい。二つの希望を両立させたいと考えるサイト運営者も多いでしょう。
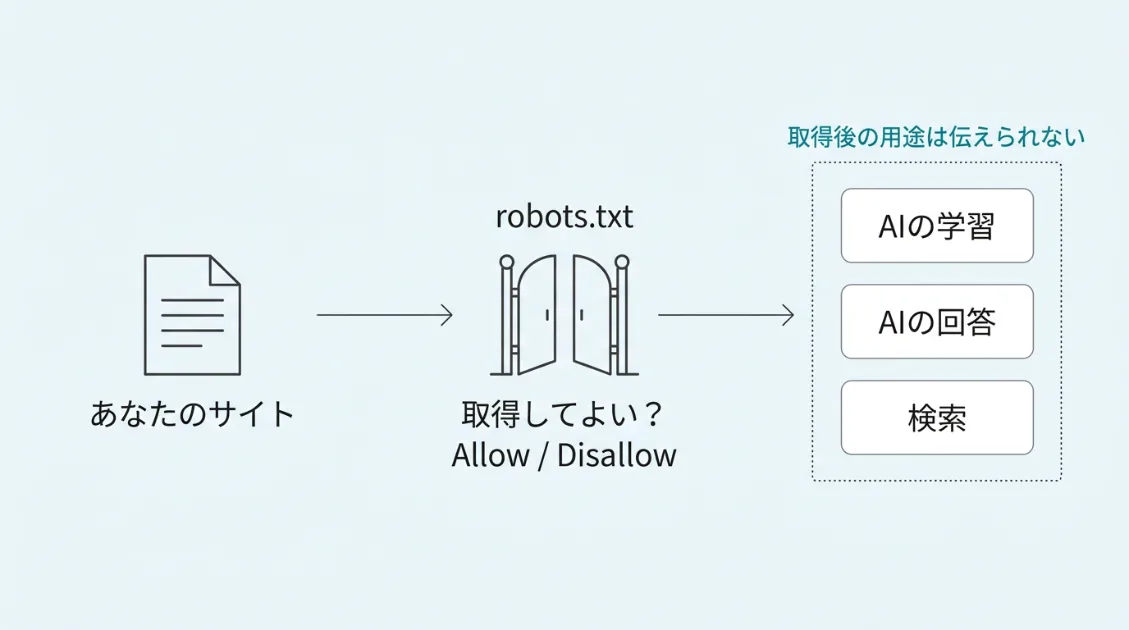
従来のrobots.txtにあるAllow/Disallowは、基本的に「どのページを取得してよいか」をクローラーに伝えるものです。「取得はよいけれど、AIの学習には使わないでほしい」といった、取得後の用途に対する希望を共通の書式で伝える仕組みではありません。
用途ごとに希望を伝える共通の仕組みをつくろうと、インターネットの技術標準を策定するIETFの「aipref(AI Preferences)」ワーキンググループで議論が進んでいます。現在の案では、robots.txtに「AIの学習には使わないでください」という希望を示す1行を追加する方法などが提案されています。
しかしながら、aiprefは2026年10月時点でまだ策定中の案で、書いたからといって必ず守られるわけではありません。本記事では、aiprefでできることとできないことを、最新のドラフトをもとに順番に整理します。
2026年11月2日追記:2026年10月30日、OpenAI・Google・Microsoftが、robots.txtでAI学習への利用を断る共通の書き方「__usage_ai-training」に対応すると発表しました。Anthropicも実装を始めたとしています。本記事で紹介するContent-Usageとは別の書き方のため、「10月30日:大手4社が別の書き方への対応を表明」で違いを整理しています。
この記事でわかること|📖:約8分
- 10月30日に大手4社が対応を表明した「__usage_ai-training」とのちがい
- 従来のrobots.txtでは、取得後の用途を指定しにくい理由
- aiprefで区別しようとしている3つの用途(AIの学習・AIの回答・検索)
- robots.txtへの書き方と、Cloudflareの書式とのちがい
- 書いても防げないことと、今のうちに整理しておきたいこと
robots.txtだけでは、何が足りなかった?
robots.txtは、サイトの入口に置く「立ち入りのルール表」のようなファイルです。Allow(入ってよい)とDisallow(入らないでください)を使って、クローラーにどのページを取得してよいかを伝えます。
従来のAllow/Disallowで伝えられるのは、ページを取得してよいかどうかです。取得したページを、AIの学習に使うのか、AIの回答に使うのか、検索結果に使うのかといった取得後の用途を指定するためのルールではありません。
今はクローラーの名前で分けています
用途を分けたいとき、今のサイト運営者はクローラーの名前(ユーザーエージェント)ごとにルールを書き分けています。たとえばOpenAIは、AIの学習に使うGPTBotと、ChatGPTの検索に使うOAI-SearchBotを別の名前で動かしています。GPTBotだけをDisallowにすれば、「学習には使わないでほしいけれど、検索には載せてほしい」という希望に近い設定ができます。
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /名前で分ける方法には、3つの弱点があります
- 会社ごとにルールがばらばらです。クローラーの名前も役割の分け方も各社が独自に決めているため、AI企業ごとに調べて書き分ける必要があります。
- 新しいクローラーへの対応が必要です。クローラーごとに用途を分ける方法では、新しい名前や役割の変更を確認し、必要に応じてルールを更新しなければなりません。
- 1つのクローラーが複数の用途を持つと分けられません。取得したページを広告にも学習にも使うクローラーがあった場合、Disallowにすると広告まで止まってしまいます。名前単位の指定では「取得はよいけれど、学習には使わないで」とは伝えられません。
用途を伝える方法として検討されているのが、クローラーの名前ではなく、取得したあとの「用途」に対して希望を伝える共通の仕組みです。aiprefは、「学習には使わないでほしい」「検索には使ってよい」といった希望を、各社が共通して読み取れる形で示せるようにする取り組みです。
aiprefで、何を伝えられるようになる?
aiprefの案では、取得したページの使い道を3つの「用途」に分けて、用途ごとに「使ってよい」か「使わないでほしい」かを伝えます。2026年9月14日公開のドラフト(vocab-08)で提案されている用途は、次の3つです。
| ラベル | 用途 | 具体的には |
|---|---|---|
train-ai |
AIの学習 | 文章や画像などを生成するAIモデルの学習に、ページの内容を使うこと |
ai-use |
AIへの入力 | ページの内容を、生成AIへの入力として使うこと(AIが回答のために参考資料として読む場面など) |
search |
検索 | 検索結果にページを表示し、元のページへのリンクで案内すること(要約の生成は含まない) |
「学習」と「入力」を分けて伝えられます
読者にとって大きいのは、train-aiとai-useが別の用途として分かれている点です。train-aiは、文章や画像などを生成するAIモデルの学習にページを使うことを指します。ai-useは、ページの内容を生成AIへの入力として使うことです。たとえば、AIが質問に答えるためにページを取得し、参考資料として読み込む場面が当てはまります。ただし、ユーザーが直接提供したコンテンツは、現在の案では対象から除かれています。
用途が分かれているため、「AIを育てる材料にはしないでほしいけれど、AIが答えるときの参考資料としては読んでほしい」という希望も表せます。
使ってよいなら「y」、使わないでほしいなら「n」
希望は、用途のラベルにy(使ってよい)かn(使わないでほしい)を組み合わせて書きます。たとえば、train-aiを拒否し、ai-useとsearchを許可する希望は、次のように表します。
train-ai=n, ai-use=y, search=yですが、上の書き方で、あらゆるAI学習を拒否できるわけではありません。現在の案では、一定の条件を満たす検索サービス内部のAI学習は、searchに含まれます。検索の扱いについては、次の章で説明します。
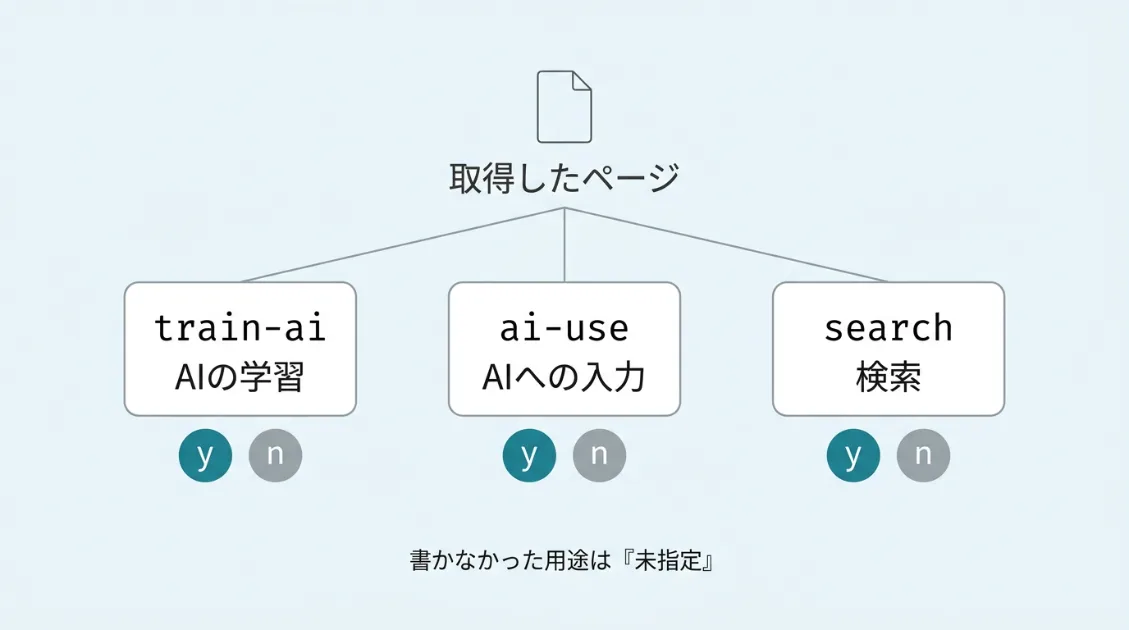
もう1つ注意したい点が、書かなかった用途の扱いです。書かなかった用途は、許可でも拒否でもなく「希望が未指定」として扱われます。未指定の用途を受け手がどう扱うかについて、ドラフトでは共通の初期設定を定めていません。希望を明確に伝えたい用途には、yかnを記載します。
なお、3つの用途の定義は、まだワーキンググループで合意されたものではありません。とくに「検索」と「AIへの入力」の境目は、今まさに議論が続いています。次の章で、どこまで決まっていて、どこが論点になっているのかを整理します。
今どこまで決まっている?まだ策定中。「検索」と「AI利用」の境界が論点
aiprefは、IETFのワーキンググループで議論が続いている段階です。2026年10月31日時点で、正式な標準(RFC)にはなっていません。以下で紹介する書き方や用途の定義は、すべて策定中の案です。
2つのドラフトで話し合われています
aiprefの議論は、役割の違う2つの文書(ドラフト)に分かれています。
| ドラフト | 決めること | バージョン・公開日 |
|---|---|---|
| 語彙(vocab) | どんな用途を区別するか(train-ai・ai-use・search) |
vocab-08(2026年9月14日) |
| 付け方(attach) | 希望をrobots.txtやHTTPヘッダーにどう書くか | attach-05(2026年8月19日) |
付け方のドラフトには、Google所属のGary Illyes氏とMozilla所属のMartin Thomson氏が著者として記載されています。ただし、著者の所属は、各社による採用や対応予定を示すものではありません。
一方で、語彙のドラフトの冒頭には、内容の全体も一部も、ワーキンググループの合意を反映したものではないと明記されています。用途の種類や定義は、今後の議論で変わる可能性があります。
論点1:「検索」はどこまでを指す?
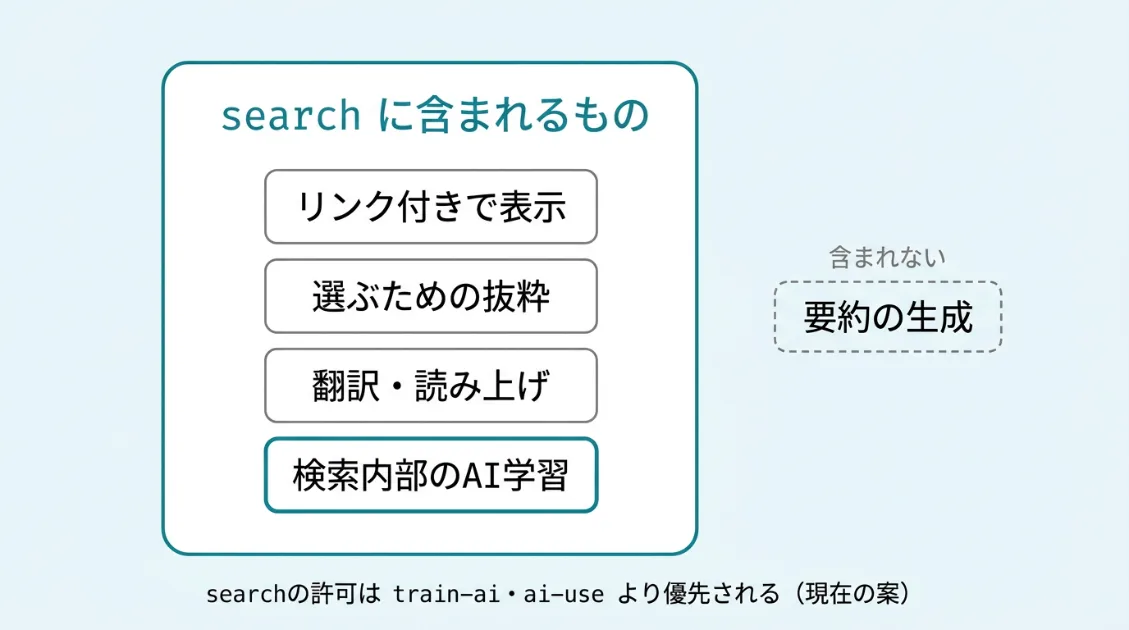
現在の案では、searchは「ページを選び出して、元の場所へ利用者を案内する」用途とされています。searchに入るのは、次の条件を満たす使い方です。
- 検索結果にページを表示するとき、元のページへのリンクを示すこと
- 本文の抜粋を表示する場合は、利用者が結果を選ぶ手助けのためであること
タイトルや抜粋の表示、翻訳や読み上げのような使いやすくするための変換も、searchに含まれます。反対に、ページの内容から要約をつくることは、searchには含まれません。
見落としやすいのは、検索サービスの内部で行う処理の扱いです。現在の案では、searchを許可すると、検索サービス内部でのAI学習も許可に含まれます。学習したAIや出力を、上の条件を守った検索の中だけで使う場合に限られます。さらに、searchの許可は、train-aiやai-useより優先されます。
つまり、「search=yとtrain-ai=nを書けば、あらゆるAI学習を断れる」とは言えません。どこまでを「検索」に含めるかは、サイト運営者の希望がどの用途に適用されるかを左右する重要な論点です。
論点2:「ユーザーが直接提供した」はどこまで?
ai-useからは、ユーザーが直接提供したコンテンツが除かれています。たとえば、ユーザーが自分で文章を貼り付けて「要約して」とAIに頼む場合は、ai-useの対象外です。
まだ決まっていないのは、ユーザーがURLだけを貼り付けて「要約して」と頼んだ場合です。AIがURLの先のページを取得して読むとき、ユーザーが「直接提供した」と考えるかどうかは、ドラフトでも未解決の課題として残っています。
URLを指定してAIにページを読ませる場合、URLの扱いがどちらに決まるかによって、ai-use=nと書いたときに断れる範囲が変わります。
どうやって書くの?
10月30日:大手4社が別の書き方への対応を表明
2026年10月30日、OpenAI・Google・Microsoftが、robots.txtでAI学習への利用を断る共通の書き方に対応する方針を発表しました。Anthropicも、実装を始めたと説明しています(Google Search Central Blog、gihyo.jp)。
発表された書き方は、本記事で紹介するContent-Usageの行を足す方法ではありません。User-Agentの行に、クローラーの名前のかわりに「学習への利用」を表す専用の名前__usage_ai-trainingを書く方法です。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/上の例は、サイト全体のAI学習への利用を断り、/press-kit/以下だけを許可する、という意味です。巡回を止める指定ではなく、取得したページを学習に使うかどうかの希望を伝えるものです。
| Content-Usage(attach-05) | __usage_ai-training(10月30日の草案) | |
|---|---|---|
| 書き方 | robots.txtにContent-Usageの行を追加 |
User-Agentの行に専用の名前を書き、Disallow/Allowで指定 |
| 伝えられる用途 | 学習・AIへの入力・検索の3つ | AIの学習だけ |
| 文書の位置づけ | ワーキンググループの付け方のドラフト | AnthropicのKevin Kelley氏が個人として提出した草案。IETFが承認した標準ではない |
| 大手の対応表明 | 今回の発表には含まれていない | OpenAI・Google・Microsoftが対応予定、Anthropicが実装中 |
各社が示した対応の時期は、次のとおりです。
- Google:2027年初めに対応予定。
__usage_ai-trainingで学習を断った場合、Google-Extendedを拒否したのと同じ扱いにする方針です(Google-Extendedを個別に書いていない場合) - Microsoft:2027年2月1日から適用を開始
- OpenAI:今後数か月での対応を目指すとしています
- Anthropic:実装を開始。完了時期は示されていません
注意したい点が2つあります。1つ目は、User-Agent: *のグループは、__usage_ai-trainingの指定とはみなされないことです。すべてのクローラー向けのルールを書いていても、学習への希望を伝えたことにはなりません。
2つ目は、Googleの扱いです。Google-Extendedは、AIの学習だけでなく、Geminiが回答の根拠としてサイトを使う「グラウンディング」にも関わる設定です。__usage_ai-trainingがGoogle-Extendedの拒否と同じ扱いになると、グラウンディングにも影響する可能性があります。Geminiの回答で引き続き使われたい場合は、Google-Extendedを個別に許可する書き方を検討します(PPC Land)。
Content-Usageと__usage_ai-trainingのどちらが最終的な標準になるのか、2つがどう整理されるのかは、2026年11月2日の時点では決まっていません。
現在の案では、希望を伝える方法が2つ用意されています。robots.txtに書く方法と、HTTPヘッダーで伝える方法です。どちらも書式は同じで、前の章で紹介したtrain-ai=nのような書き方を使います。
robots.txtに書く方法
robots.txtでは、Content-Usageという新しい行を追加します。全ページについて、AIの学習には使わないでほしいと伝える場合は、次のように書きます。
User-Agent: *
Allow: /
Content-Usage: train-ai=nフォルダごとに希望を変えることもできます。次の例では、サイト全体は学習を拒否し、/ai-ok/以下のページだけ学習を許可しています。
User-Agent: *
Allow: /
Content-Usage: train-ai=n
Content-Usage: /ai-ok/ train-ai=y注意したいのは、Disallowとの関係です。robots.txtのContent-Usageによる希望が付くのは、クローラーが取得を許可されているページだけです。Disallowで取得を禁止したページには、robots.txtのContent-Usageでは用途の希望が付きません。Allow/Disallowで「取得してよいか」を伝え、Content-Usageで「取得後にどう使ってほしいか」を伝える、という二段構えです。
また、クローラーは取得したrobots.txtを、通常は24時間以内の範囲で手元に保存して使い回します。書き換えた内容が伝わるのは、クローラーが新しいrobots.txtを読み直し、ページを取得し直したあとです。すでに取得されたページに、さかのぼって希望が付くわけではありません。
HTTPヘッダーで伝える方法
もう1つは、ページを返すときのHTTPヘッダーにContent-Usageを付ける方法です。ページごとに細かく希望を変えたい場合に向いています。
HTTP/1.1 200 OK
Content-Type: text/html
Content-Usage: train-ai=n
HTTPヘッダーの追加は、サーバーの設定ファイルやプラグインで行います。設定方法はサーバーによって異なるため、利用しているサーバーの説明書を確認してください。
robots.txtとHTTPヘッダーの両方に書いて、内容が食い違った場合は、別の解決方法がない限り、同じ用途については拒否が優先されます。たとえば、robots.txtでtrain-ai=y、HTTPヘッダーでtrain-ai=nと書くと、学習は拒否として扱われます。
Cloudflareの「Content-Signal」とは書式が違います
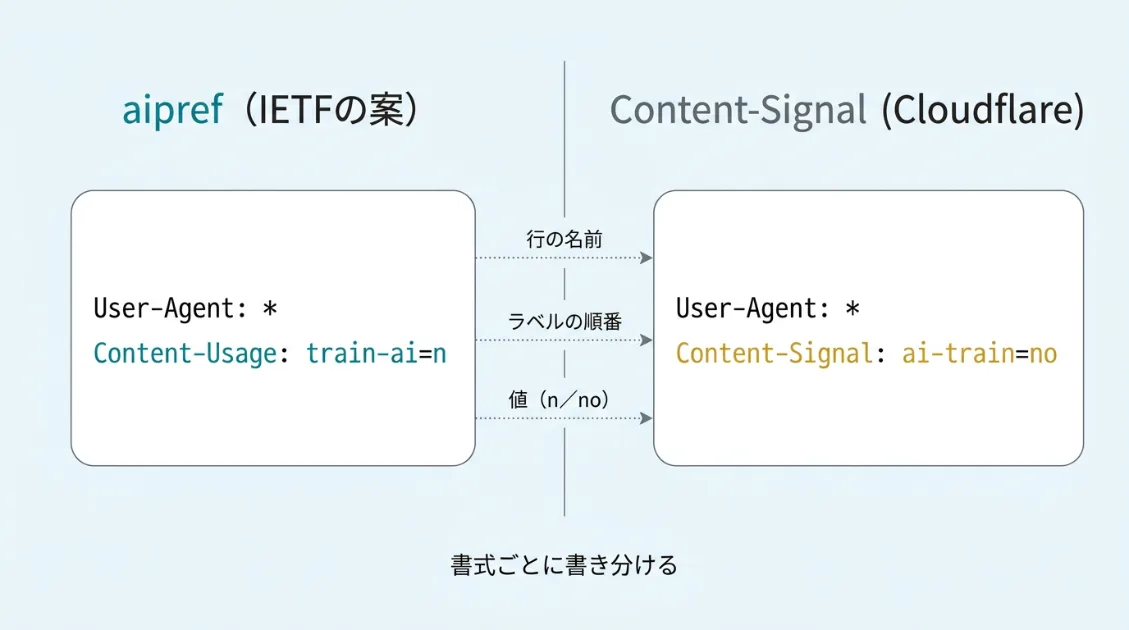
robots.txtで用途を伝える仕組みには、Cloudflareが独自に広めている「Content-Signal」もあります。目的は似ていますが、aiprefとは別の仕組みで、行の名前や一部のラベル、値の書き方が違います。
| aipref(IETFの案) | Content-Signal(Cloudflare) | |
|---|---|---|
| 行の名前 | Content-Usage |
Content-Signal |
| 学習 | train-ai |
ai-train |
| AIへの入力 | ai-use |
ai-input |
| 検索 | search |
search |
| 値 | y / n |
yes / no |
| 記述例 | Content-Usage: train-ai=n |
Content-Signal: ai-train=no |
train-aiとai-trainのように、単語の順番が逆になっている点が特にまぎらわしいところです。行の名前・用途のラベル・値は、各書式に合わせて記載してください。たとえば、aiprefのContent-Usageにtrain-ai=noと書いても、学習を拒否する指定としては認識されません。
コピペで失敗しやすい書き方
書き間違えても、設定画面などにエラーが表示されるとは限りません。知らないラベルは無視され、値が不適切な用途は「希望が未指定」として扱われます。また、書式自体を読み取れない場合は、指定全体が未指定になることもあります。書いたつもりでも希望が伝わっていない可能性があるため、注意が必要です。
失敗しやすい書き方の一覧を見る
| 書き方 | どうなる? | 理由 |
|---|---|---|
train-ai=no |
学習の希望が未指定 | 値はyかnだけ。noやyesは読み取られない |
train-ai="n" |
学習の希望が未指定 | 値を引用符で囲むと、y/nとして扱われない |
ai=n |
無視される | 以前の案にあったラベル。現在の案にないラベルは無視される |
Train-AI=n |
指定全体の読み取りに失敗 | 大文字と小文字を区別する。大文字が混ざると、同じ行にあるほかの用途も含めて未指定になる |
ネット上には、以前の案をもとにした記述例も残っています。ラベルはtrain-ai・ai-use・searchの3つ、値は小文字のyかnだけと覚えておくと、書き間違いを防げます。
書けば、AIは守ってくれる?
aiprefは、サイト運営者の希望を伝えるための仕組みです。書いても、AIによる取得や利用を技術的に止められるわけではありません。Content-Usageは「用途に関する意思表示」を伝えるもので、ページを取得できないようにする鍵ではないからです。人に見せたくない情報を確実に守りたい場合は、ログインやアクセス制限など、別の方法が必要です。
希望を受け取った側が従うかどうかも、仕様では保証していません。ドラフトでは、希望に従うか、どんな場合に従わないかは仕様の範囲外としています。法律や契約によって従う義務が生まれるかどうかも、仕様では扱っていません。たとえば、サイト運営者とAI企業の間に個別の契約がある場合は、robots.txtの希望より契約の内容が優先されることもある、と説明されています。
10月30日の発表で、大手4社が__usage_ai-trainingへの対応を表明しました。ただし、各社の対応は任意の取り組みで、草案にも守らせる仕組みはありません。発表した4社のほかのAI企業が従うかどうかもわかりません。
もう1つの課題は、各社の対応が外から見えにくいことです。サイト側のアクセスログだけでは、取得されたページが何に使われたかまでは確認できません。クローラーがページを取得した記録があっても、学習に使ったのか、回答の参考資料にしたのかはわかりません。また、取得後の用途を制限する仕組みなので、希望が守られていてもアクセスの動きが変わらない場合があります。
AI観測ラボでは、2026年10月31日から、テスト用ページにContent-Usageを設定し、クローラーのアクセスに変化があるかを観測しています。設定前後を比べるため、11月末までは書き方を変えずに観測を続けます。アクセスの観測だけで学習や回答への利用、希望の遵守を判定することはできませんが、確認できた動きと観測の限界を、別の記事で紹介します。
サイト運営者は、今なにをすればいい?
aiprefはまだ策定中の案なので、急いでrobots.txtに書き加える必要はありません。今のうちにやっておきたいのは、自分のサイトで許容する用途と、現在の設定を整理しておくことです。確認しておきたいのは、次の3つです。
1. 自分のサイトで許したい用途を整理する
まず、AIの学習・AIへの入力・検索の3つについて、自分のサイトでは許したいのか、断りたいのかを考えておきます。たとえば、AIの回答で紹介されることが集客につながるサイトなら、AIへの入力と検索は許したいと考えるかもしれません。用途ごとの考えがまとまっていれば、仕様が固まったときに、導入するかどうかを判断しやすくなります。
2. 今のrobots.txtの設定を確認する
現在の設定を確認するには、自分のサイトのドメイン直下にあるrobots.txtをブラウザで開きます。サイトがhttps://example.com/なら、確認する場所はhttps://example.com/robots.txtです。どのAIクローラーを許可し、どれを止めているかを把握しておきましょう。
クローラー名ごとの指定については、各社の公式説明で用途と設定方法を確認します。aiprefの導入を検討する場合も、既存のAllow/Disallowによる取得ルールと、用途に関する希望を分けて考えることが大切です。
クローラーからのアクセス状況は、サーバーのアクセスログで確認できます。WordPressのサイトなら、AIクローラーの訪問を記録するプラグインAI Kansoku Lab Trackerを使う方法もあります。ただし、アクセスの記録だけでは、取得されたページの利用目的までは確認できません。
3. 仕様の更新と各社の対応状況を確認する
aiprefのドラフトは、今後も内容が変わる可能性があります。導入するかどうかは、仕様の更新と、対象のクローラーが対応を公表しているかを確認して判断しましょう。標準化の進み具合に加えて、各社のクローラーの説明ページも確認しておくとよいでしょう。
試しに記載する場合は、その時点のドラフトに合わせ、許可したい用途にはy、拒否したい用途にはnを指定します。AIの学習を断りたい場合は、大手4社が対応を表明した__usage_ai-trainingの書き方もあわせて確認しておきましょう。どちらの書き方も、記載するだけで取得や利用を防げるわけではない点を押さえておきましょう。

自分のサイトに、どのAIクローラーが来ている?
robots.txtの設定を見直す前に、まずは実際の訪問を確認しましょう。WordPressプラグイン「AI Kansoku Lab Tracker」を入れると、AIクローラーの訪問をページごとに記録できます。
あなたのサイトは、
AIに見えていますか?
URLを入力するだけで30秒。8項目を自動診断し、優先度別の改善プランを提示します。完全無料・登録不要。


